J~杰's Blog

人生就一条路,走一步有一步的景观

0%

大家在初次使用spring-cloud的gateway的时候,肯定会被里面各种的Timeout搞得晕头转向。hytrix有设置,ribbon也有。我们一开始也是乱设一桶,Github上各种项目里也没几个设置正确的。对Timeout的研究源于一次log中的warning

o.s.c.n.z.f.r.s.AbstractRibbonCommand : The Hystrix timeout of 60000ms for the command pay is set lower than the combination of the Ribbon read and connect timeout, 111000ms.

hytrix超时时间

log出自AbstractRibbonCommand.java,那么索性研究一下源码

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
protected static int getHystrixTimeout(IClientConfig config, String commandKey) {
int ribbonTimeout = getRibbonTimeout(config, commandKey);
DynamicPropertyFactory dynamicPropertyFactory = DynamicPropertyFactory.getInstance();

// 获取默认的hytrix超时时间
int defaultHystrixTimeout = dynamicPropertyFactory.getIntProperty("hystrix.command.default.execution.isolation.thread.timeoutInMilliseconds",
0).get();
// 获取具体服务的hytrix超时时间,这里应该是hystrix.command.foo.execution.isolation.thread.timeoutInMilliseconds
int commandHystrixTimeout = dynamicPropertyFactory.getIntProperty("hystrix.command." + commandKey + ".execution.isolation.thread.timeoutInMilliseconds",
0).get();
int hystrixTimeout;
// hystrixTimeout的优先级是 具体服务的hytrix超时时间 > 默认的hytrix超时时间 > ribbon超时时间
if(commandHystrixTimeout > 0) {
hystrixTimeout = commandHystrixTimeout;
}
else if(defaultHystrixTimeout > 0) {
hystrixTimeout = defaultHystrixTimeout;
} else {
hystrixTimeout = ribbonTimeout;
}
// 如果默认的或者具体服务的hytrix超时时间小于ribbon超时时间就会警告
if(hystrixTimeout < ribbonTimeout) {
LOGGER.warn("The Hystrix timeout of " + hystrixTimeout + "ms for the command " + commandKey +
" is set lower than the combination of the Ribbon read and connect timeout, " + ribbonTimeout + "ms.");
}
return hystrixTimeout;
}

紧接着,看一下我们的配置是什么

1
2
3
4
5
6
7
8
9
10
11
12
13
hystrix:
command:
default:
execution:
isolation:
thread:
timeoutInMilliseconds: 600000

ribbon:
ReadTimeout: 50000
ConnectTimeout: 500
MaxAutoRetries: 0
MaxAutoRetriesNextServer: 1

ribbon超时时间
这里ribbon的超时时间是111000ms,那么为什么log中写的ribbon时间是50000ms?

继续分析源码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
protected static int getRibbonTimeout(IClientConfig config, String commandKey) {
int ribbonTimeout;
// 这是比较异常的情况,不说
if (config == null) {
ribbonTimeout = RibbonClientConfiguration.DEFAULT_READ_TIMEOUT + RibbonClientConfiguration.DEFAULT_CONNECT_TIMEOUT;
} else {
// 这里获取了四个参数,ReadTimeout,ConnectTimeout,MaxAutoRetries, MaxAutoRetriesNextServer
int ribbonReadTimeout = getTimeout(config, commandKey, "ReadTimeout",
IClientConfigKey.Keys.ReadTimeout, RibbonClientConfiguration.DEFAULT_READ_TIMEOUT);
int ribbonConnectTimeout = getTimeout(config, commandKey, "ConnectTimeout",
IClientConfigKey.Keys.ConnectTimeout, RibbonClientConfiguration.DEFAULT_CONNECT_TIMEOUT);
int maxAutoRetries = getTimeout(config, commandKey, "MaxAutoRetries",
IClientConfigKey.Keys.MaxAutoRetries, DefaultClientConfigImpl.DEFAULT_MAX_AUTO_RETRIES);
int maxAutoRetriesNextServer = getTimeout(config, commandKey, "MaxAutoRetriesNextServer",
IClientConfigKey.Keys.MaxAutoRetriesNextServer, DefaultClientConfigImpl.DEFAULT_MAX_AUTO_RETRIES_NEXT_SERVER);
// 原来ribbonTimeout的计算方法在这里,以上文的设置为例
// ribbonTimeout = (50000 + 50000) * (0 + 1) * (1 + 1) = 200000
ribbonTimeout = (ribbonReadTimeout + ribbonConnectTimeout) * (maxAutoRetries + 1) * (maxAutoRetriesNextServer + 1);
}
return ribbonTimeout;
}

可以看到ribbonTimeout是一个总时间,所以从逻辑上来讲,作者希望hystrixTimeout要大于ribbonTimeout,否则hystrix熔断了以后,ribbon的重试就都没有意义了。

ribbon单服务设置

到这里最前面的疑问已经解开了,但是hytrix可以分服务设置timeout,ribbon可不可以? 源码走起,这里看的文件是DefaultClientConfigImpl.java

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
// 这是获取配置的入口方法,如果是null,那么用默认值
// 所有ribbon的默认值的都在该类中设置了,可以自己看一下
public <T> T get(IClientConfigKey<T> key, T defaultValue) {
T value = get(key);
if (value == null) {
value = defaultValue;
}
return value;
}
// 这是核心方法
protected Object getProperty(String key) {
if (enableDynamicProperties) {
String dynamicValue = null;
DynamicStringProperty dynamicProperty = dynamicProperties.get(key);
// dynamicProperties其实是一个缓存,首次访问foo服务的时候会加载
if (dynamicProperty != null) {
dynamicValue = dynamicProperty.get();
}
// 如果缓存没有,那么就再获取一次,注意这里的getConfigKey(key)是生成key的方法
if (dynamicValue == null) {
dynamicValue = DynamicProperty.getInstance(getConfigKey(key)).getString();
// 如果还是没有取默认值,getDefaultPropName(key)生成key的方法
if (dynamicValue == null) {
dynamicValue = DynamicProperty.getInstance(getDefaultPropName(key)).getString();
}
}
if (dynamicValue != null) {
return dynamicValue;
}
}
return properties.get(key);
}

小结

感觉ribbon和hytrix的配置获取源码略微有点乱,所以也导致大家在设置的时候有些无所适从。spring-cloud的代码一直在迭代,无论github上还是文档可能都相对滞后,这时候阅读源码并且动手debug一下是最能接近事实真相的了。

背景

开发写代码一直想脱离鼠标操作,看起来高大上一点,最近开始idea用vim操作。以下是vim的简单快捷键。

keymap 记录

  • 跳转到指定行:{行数}g
  • 标签特切换:gt或者gT,前者顺序切换,后者逆向切换
  • 单词移动:w/W,移动到下个单词开头;b/B,倒退到上个单词开头。大写的会忽略标点。命令前加数字表示执行次数,如2W
  • 删除当前单词并进入插入模式:cw
  • 撤销:u;恢复被撤销的操作:ctrl+r
  • v进入选择字符,V进入行选择模式
  • 用y命令将文本存入寄存器,普通模式下小写p把寄存器内容复制到当前位置之后,大写P把寄存器内容复制到当前位置之前
  • 剪切操作,先v选择多行,然后d删除,最后到需要粘贴的地方p
  • 跳转到特定行,按:n 如 :23 跳转到23行
  • x(小写) -> 正向按字符单位进行删除 向右删除
  • X(大写) -> 反向按字符单位进行删除 向左删除
  • $ -> 当前行的最后一个字符
  • G -> 跳转到最后一行

组合技巧

  • 全选: ggvG
  • 调换两个字符位置: xp
  • 复制一行: yyp
  • 调换两行位置: ddp
  • 复制后,在命令模式下 np n代表数字你想要粘贴的数目,如 10p

枚举法

通过在配置文件中配置可能的枚举id,自己配置分片,本规则适用于特定的场景,比如有些业务需要按照省 份或区县来做保存,而全国省份区县固定的,这类业务使用本条规则,配置如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
<tableRule name="sharding-by-intfile">
<rule>
<!--标识将要分片的表字段-->
<columns>user_id</columns>
<!--分片函数-->
<algorithm>hash-int</algorithm>
</rule>
</tableRule>
<function name="hash-int" class="com.dxy.mycat.route.function.PartitionByFileMap">
<!--标识配置文件名称-->
<property name="mapFile">partition-hash-int.txt</property>
<!--type默认值为0,0表示Integer,非零表示String-->
<property name="type">0</property>
<!--所有的节点配置都是从0开始,及0代表节点1-->
<property name="defaultNode">0</property>
</function>

partition-hash-int.txt 配置:

1
2
3
10000=0
10010=1
DEFAULT_NODE=1

配置说明:

上面 columns 标识将要分片的表字段,algorithm 分片函数,其中分片函数配置中,mapFile 标识配置文件名称,type为分片字段的类型,默认值为 0,0 表示 Integer,非零表示 String, 所有的节点配置都是从 0 开始,及 0 代表节点 1;defaultNode 默认节点:小于 0 表示不设置默认节点,大于等于 0 表示设置默认节点,默认节点的作用:枚举分片时,如果碰到不识别的枚举值,就让它路由到默认节点;如果不配置默认节点(defaultNode 值小于 0 表示不配置默认节点),碰到不识别的枚举值就会报错

Read more »

Haproxy

HAProxy是一个使用C语言编写的自由及开放源代码软件,其提供高可用性、负载均衡,以及基于TCP和HTTP的应用程序代理。

HAProxy特别适用于那些负载特大的web站点,这些站点通常又需要会话保持或七层处理。HAProxy运行在当前的硬件上,完全可以支持数以万计的并发连接。并且它的运行模式使得它可以很简单安全的整合进您当前的架构中, 同时可以保护你的web服务器不被暴露到网络上。

安装依赖包

依赖gcc和make安装包

sudo apt-get build-dep gcc

安装完了可以执行如下的命令来查看版本,

gcc –version

安装make安装包

sudo apt install ubuntu-make

下载

1
2
3
[root@haproxy-server-master ~]# cd /home/dxy/temp/
[root@haproxy-server-master src]# wget http://pkgs.fedoraproject.org/repo/pkgs/haproxy/haproxy-1.7.9.tar.gz/sha512/d1ed791bc9607dbeabcfc6a1853cf258e28b3a079923b63d3bf97504dd59e64a5f5f44f9da968c23c12b4279e8d45ff3bd39418942ca6f00d9d548c9a0ccfd73/haproxy-1.7.9.tar.gz
[root@haproxy-server-master src]# tar -xvf haproxy-1.7.9.tar.gz
Read more »

keepalived 安装

直接通过apt-get方式安装最简单

1
2
3
4
[root@bogon /]# apt-get install libssl-dev openssl libpopt-dev
[root@bogon /]# apt-get install -y keepalived
[root@bogon /]# keepalived -v
[root@bogon /]# Keepalived v1.2.13 (08/03,2017)

编写 Haproxy 状态监测

1
2
3
4
5
6
7
8
9
10
[root@bogon /]# vim /etc/keepalived/check_haproxy.sh
#!/bin/sh
if [ $(ps -C haproxy --no-header | wc -l) -eq 0 ]; then
/home/dxy/haproxy/sbin/haproxy -f /home/dxy/haproxy/conf/haproxy.cfg
fi

sleep 2
if [ $(ps -C haproxy --no-header | wc -l) -eq 0 ]; then
killall keepalived
fi
Read more »

环境准备

安装与部署

平台组有提供编译好的安装包,支持 windows、Linux、Mac、Solaris 等系统上安装与运行。
解压安装包建议放在 /usr/local/Mycat 目录下,创建mycat用户,改变目录权限为mycat

1
2
3
$ tar zxf Mycat-server-1.6-RELEASE-20161028204710-linux.tar.gz
$ useradd mycat
$ chown -R mycat.mycat /usr/local/mycat

mysql设置

通过部署发现在Mycat中部署逻辑表表名大小写混合时,在Mycat连接后出现全变小,所以需要修改mysql不忽略表名大小写,需要手动到/etc/my.cnf 下配置

lower_case_table_names=1

环境变量设置

1
2
3
$ vim /etc/profile
MYCAT_HOME=/usr/local/mycat
source /etc/profile
Read more »

背景

目前公司业务高速发展,各种业务数据呈井喷的态势,单表数据量急剧膨胀,随之而来是单表读写性能和吞吐量呈下降趋势而且无法应对业务高速增长产生的数据。因此需要使用分库分表机制保证高性能同时支撑和驱动业务发展,选择一款功能强大支持分库分表的中间件就成为当务之急。开源的数据库中间件众多,需要从中挑选一个适合的,并能作为映客长期演进的中间件,因此需要从多个维度对中间件进行相关测试。

分库分表方案

针对数据量过大出现的性能问题,通过分库分表将数据量保持在阀值以下,可以有效分散高并发量和缓解大数据量。

分库分表一般分垂直拆分和水平拆分,根据业务将单库(表)拆分为多库(表),常用的字段和不常用的字段拆分至不同的库(表)中,可适当缓解并发量和数据量,但不能根治;垂直拆分之后依然超过单节点所能承载的阈值,则需要水平拆分来进一步处理。 水平拆分则是根据分片算法将一个库(表)拆分为多个库(表)。

分表虽然可以解决海量数据导致的性能问题,但无法解决过多请求访问同一数据库,导致其响应变慢的问题。所以水平拆分通常要采取分库的方式(合理的配合使用分库+分表),一并解决数据量和访问量巨大的问题。

分库分表问题

  1. 事物问题
    在执行分库分表之后,由于数据存储到了不同的库上,数据库事务管理出现了困难。如果依赖数据库本身的分布式事务管理功能去执行事务,将付出高昂的性能代价;如果由应用程序去协助控制,形成程序逻辑上的事务,又会造成编程方面的负担。

    解决方案:分布式事物(缺点:随着分片数量越来越多,性能代价越来越大)

  2. 跨库跨表的join问题
    在执行了分库分表之后,难以避免会将原本逻辑关联性很强的数据划分到不同的表、不同的库上,这时,表的关联操作将受到限制,我们无法join位于不同分库的表,也无法join分表粒度不同的表,结果原本一次查询能够完成的业务,可能需要多次查询才能完成。

    解决方案:解决这一问题的普遍做法是分两次查询实现。在第一次查询的结果集中找出关联数据的id,根据这些id发起第二次请求得到关联数据。

  3. 跨库跨表的count,order by,group by以及聚合函数问题
    这些是一类问题,因为它们都需要基于全部数据集合进行计算。多数的代理都不会自动处理合并工作。

    解决方案:与解决跨节点join问题的类似,分别在各个节点上得到结果后在应用程序端进行合并。和join不同的是每个结点的查询可以并行执行,因此很多时候它的速度要比单一大表快很多。但如果结果集很大,对应用程序内存的消耗是一个问题。

  4. 数据迁移,扩容等问题
    业界常用做法利用对2的倍数取余具有向前兼容的特性(如对4取余得1的数对2取余也是1)来分配数据,避免了行级别的数据迁移,但是依然需要进行表级别的迁移,同时对扩容规模和分表数量都有限制。总得来说,这些方案都不是十分的理想,多多少少都存在一些缺点,这也从一个侧面反映出了Sharding扩容的难度。

    解决方案:目前业务没有比较成熟的方案

  5. 分布式主键问题
    一旦数据库被切分到多个物理结点上,我们将不能再依赖数据库自身的主键生成机制。一方面,某个分区数据库自生成的ID无法保证在全局上是唯一的;另一方面,应用程序在插入数据之前需要先获得ID,以便进行SQL路由。

    解决方案:UUID、Snowflake、数据库序列等

分库/分表策略

分库/分表维度确定后,一般常用有两种方式:

  1. 根据数值范围,比如用户Id为1-9999的记录分到第一个库,10000-20000的分到第二个库,以此类推。
  2. 根据数值取模,比如用户Id mod n,余数为0的记录放到第一个库,余数为1的放到第二个库,以此类推。

优劣比较

对比点 范围 取模
库数量 库数量前期数目比较小,可以随用户/业务按需增长 前期即根据mode因子确定库数量,数目一般比较大
扩容 调整库数量比较容易,一般只需为新用户增加库 需要数据迁移
热点数据 有单库热点数据问题 无热点数据,均分数据

分库数量

分库数量首先和单库能处理的记录数有关,一般来说,Mysql 单库超过5000万条记录,DB压力就很大(当然处理能力和字段数量/访问模式/记录长度有进一步关系)。

在满足上述前提下,如果分库数量少,达不到分散存储和减轻DB性能压力的目的;如果分库的数量多,好处是每个库记录少,单库访问性能好,但对于跨多个库的访问,应用程序需要访问多个库,如果是并发模式,要消耗宝贵的线程资源;如果是串行模式,执行时间会急剧增加。

最后分库数量还直接影响硬件的投入,一般每个分库跑在单独物理机上,多一个库意味多一台设备。所以具体分多少个库,要综合评估,一般初次分库建议分4-8个库。

产品调研

调研分析后Mycat和Sharding-jdbc功能上比较稳定成熟,支持分库分表、读写分离、分布式主键等。Tidb目前整体比较新,成本方面高,稳定性方面待考察。

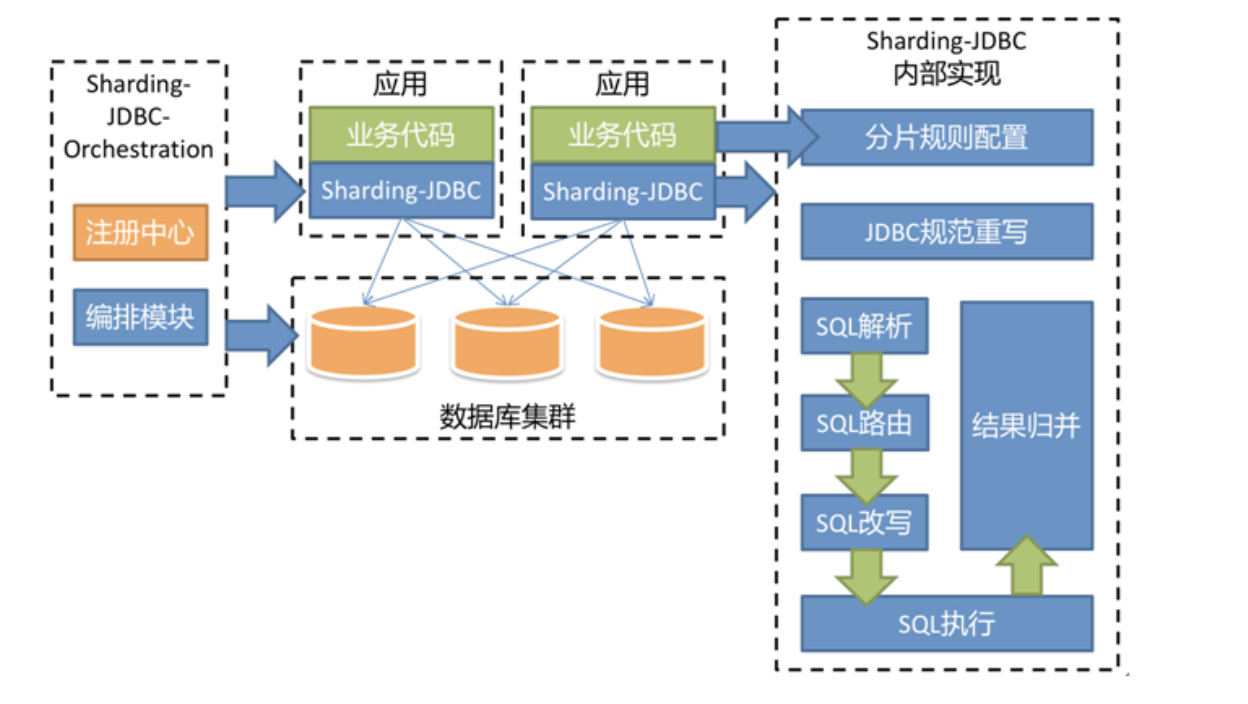
Sharding-jdbc:类似TDDL,基于JDBC协议的数据库中间件产品,使用客户端直连数据库,以jar包形式提供服务,兼容JDBC和各种ORM框架,使系统在数据访问层直接具有分片化和分布式治理的能力。

特性:

  • 轻量级框架, 直接封装的jdbc协议,jar包形式提供服务,旧代码迁移、新代码开发成本低
  • 无需额外部署和依赖,客户端直连数据库,无需二次转发,性能高
  • 运维层面不改动,无需关注中间件本身的 HA

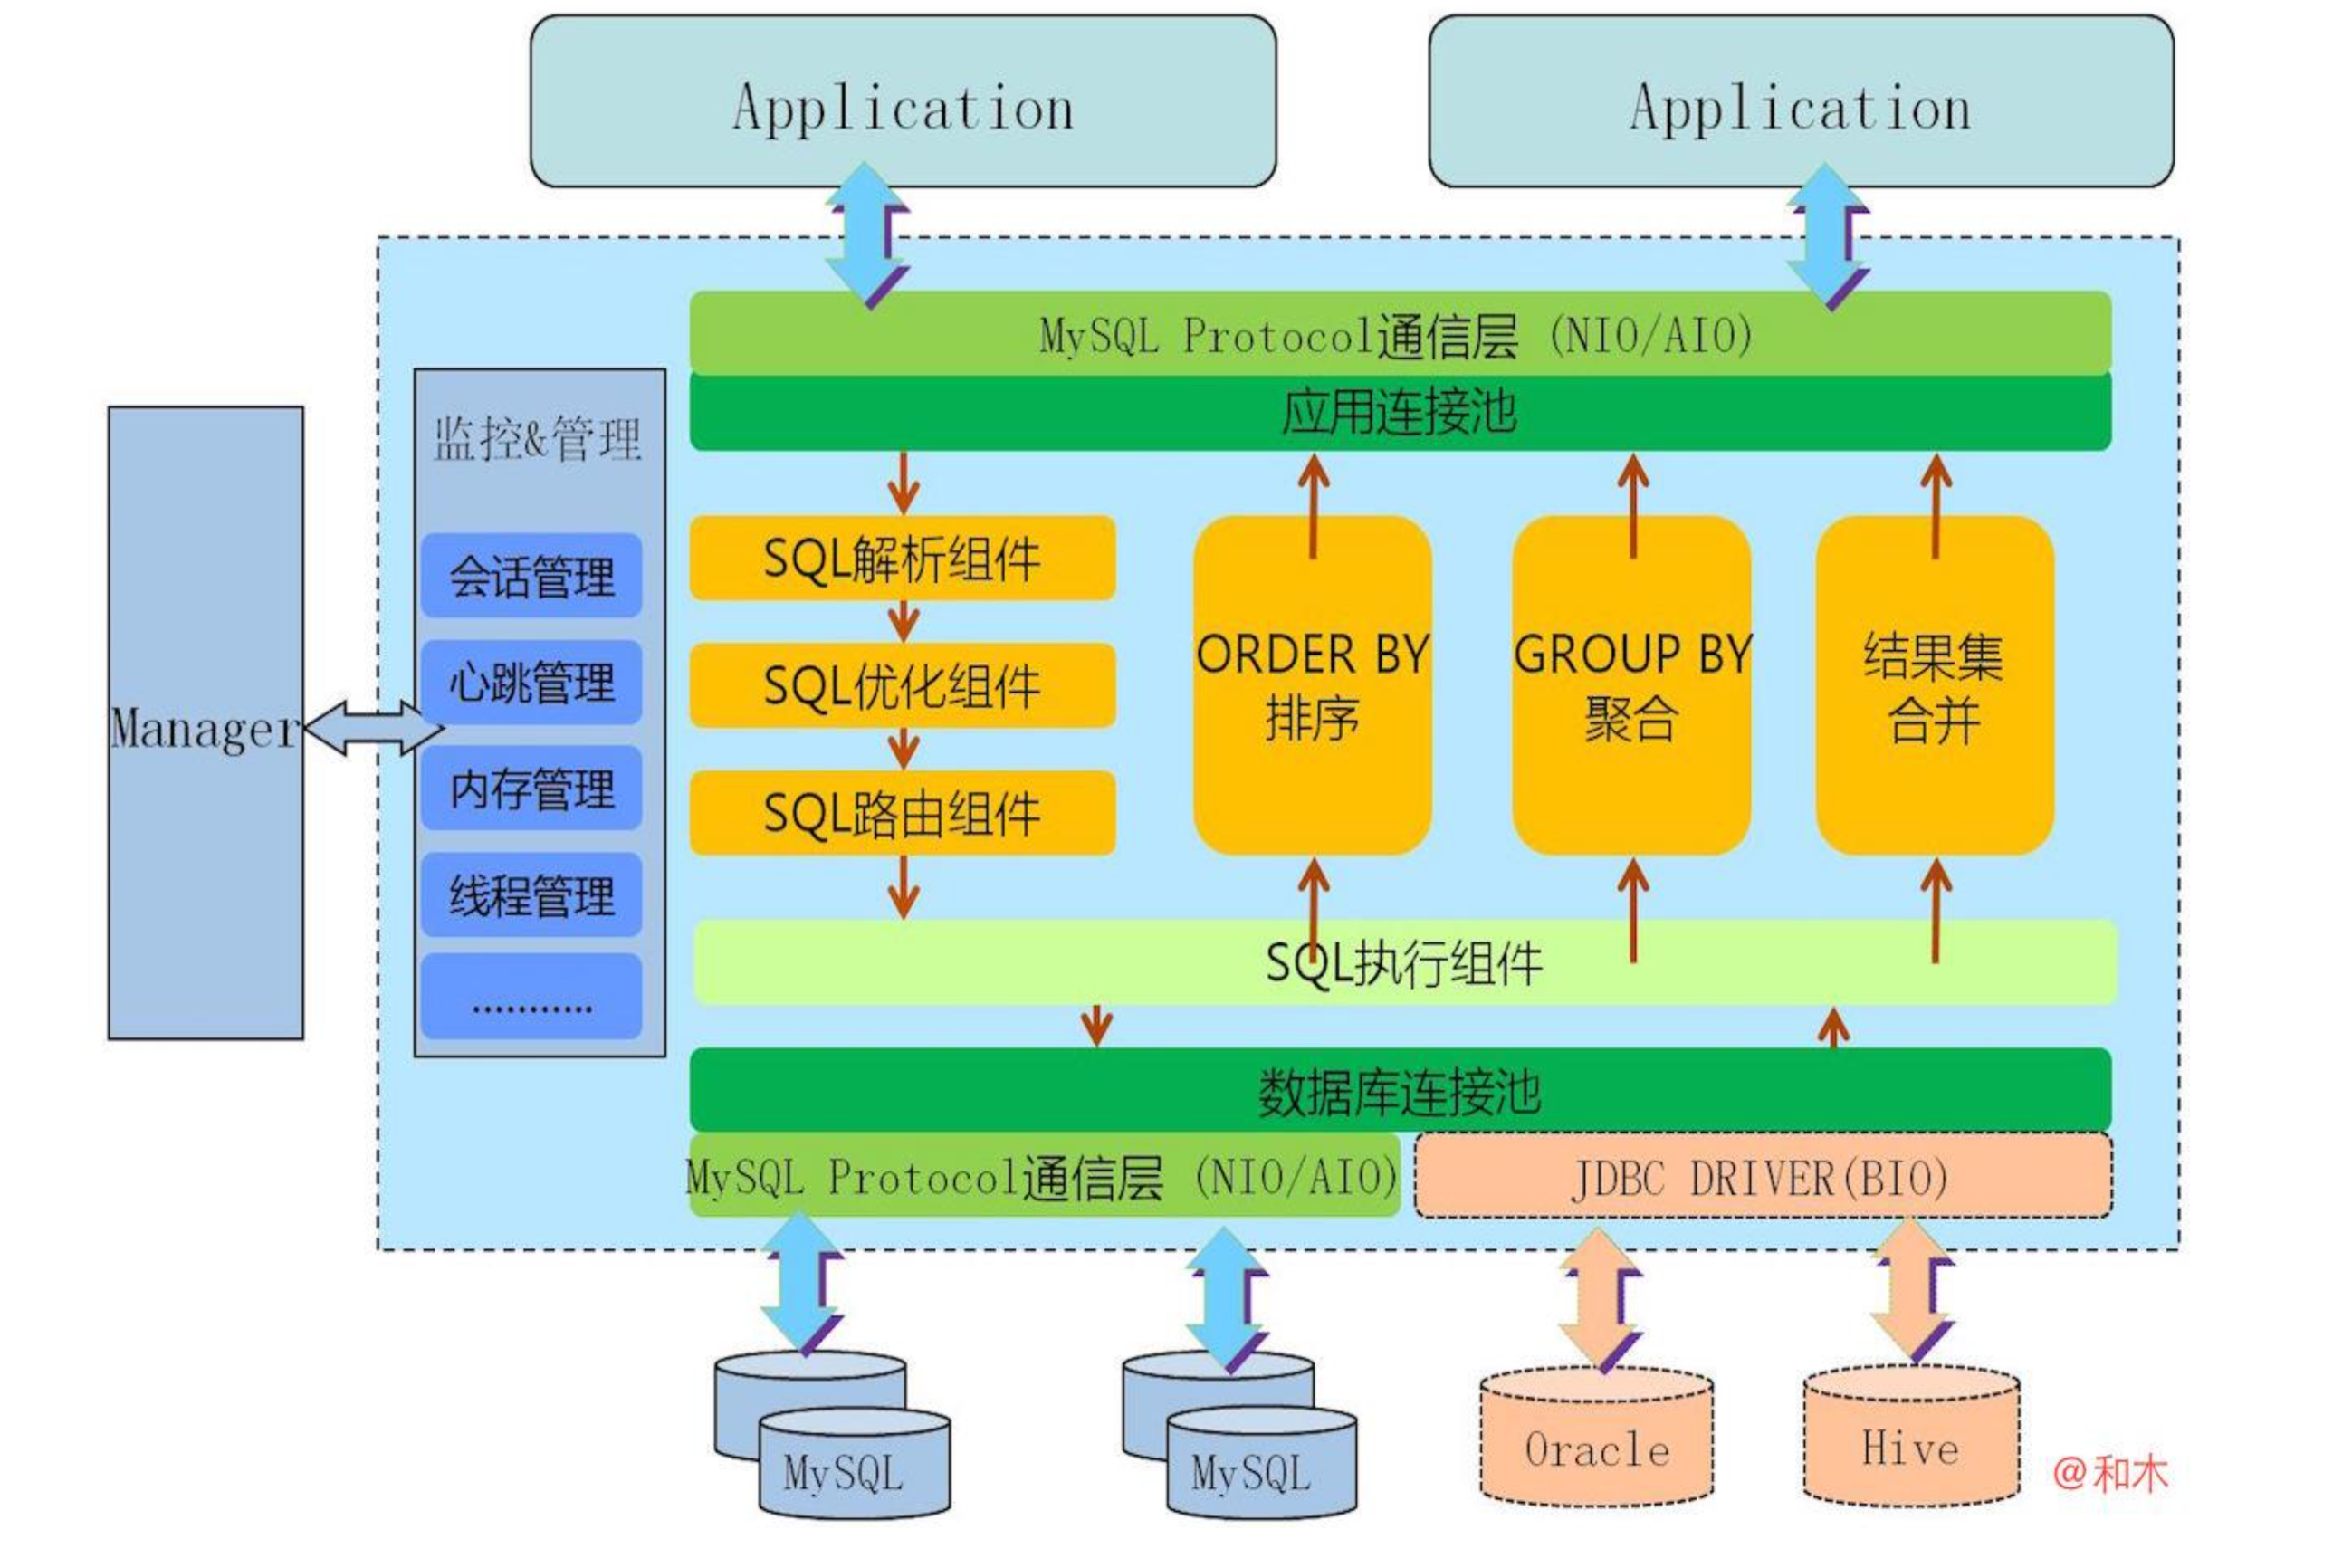
mycat:基于阿里开源的Cobar研发,对代码进行了彻底重构,使用NIO重构了网络模块,并优化了Buffer内核,增强了聚合,Join等基本特性.主要原理是拦截用户发送过来的SQL语句,对SQL语句做了特定的分析:如分
片分析、路由分析、读写分离分析、缓存分析等,然后将此SQL发往后端的真实数据库,并将返回的结果做适当的处理,最后返回给用户。

特性:

  • 可以负责更多的内容,将数据迁移,分布式事务等纳入 Proxy 的范畴
  • 针对mycat和mysql有较全性能监控项统计支持
  • 可结合Storm等分布式实时流引擎,实现数据分析和数据聚合

Tidb:实现了自动的水平伸缩,强一致性的分布式事务,基于 Raft 算法的多副本复制等重要 NewSQL 特性。 TiDB 结合了 RDBMS 和 NoSQL 的优点,部署简单,在线弹性扩容和异步表结构变更不影响业务, 真正的异地多活及自动故障恢复保障数据安全,同时兼容 MySQL 协议,使迁移使用成本降到极低。

特性:

  • SQL支持 (TiDB 是 MySQL 兼容的)
  • 水平线性弹性扩展
  • 分布式事务
  • 跨数据中心数据强一致性保证
  • 故障自恢复的高可用

架构:

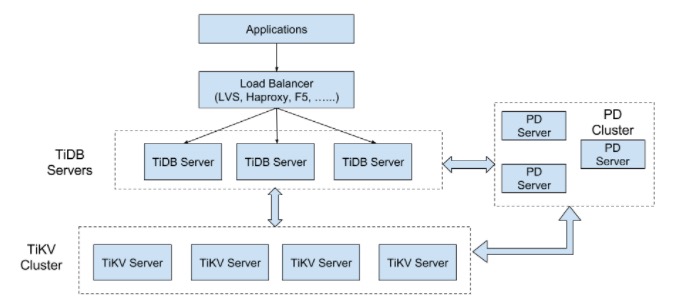
TiDB 集群主要分为三个组件:

  • TiDB Server

    TiDB Server 负责接收 SQL 请求,处理 SQL 相关的逻辑,并通过 PD 找到存储计算所需数据的 TiKV 地址,与 TiKV 交互获取数据,最终返回结果。 TiDB Server 是无状态的,其本身并不存储数据,只负责计算,可以无限水平扩展,可以通过负载均衡组件(如LVS、HAProxy 或 F5)对外提供统一的接入地址。

  • PD Server

    Placement Driver (简称 PD) 是整个集群的管理模块,其主要工作有三个: 一是存储集群的元信息(某个 Key 存储在哪个 TiKV 节点);二是对 TiKV 集群进行调度和负载均衡(如数据的迁移、Raft group leader 的迁移等);三是分配全局唯一且递增的事务 ID。
    PD 是一个集群,需要部署奇数个节点,一般线上推荐至少部署 3 个节点。

  • TiKV Server

    TiKV Server 负责存储数据,从外部看 TiKV 是一个分布式的提供事务的 Key-Value 存储引擎。存储数据的基本单位是 Region(区域),每个 Region 负责存储一个 Key Range (从 StartKey 到 EndKey 的左闭右开区间)的数据,每个 TiKV 节点会负责多个 Region 。TiKV 使用 Raft 协议做复制,保持数据的一致性和容灾。副本以 Region 为单位进行管理,不同节点上的多个 Region 构成一个 Raft Group,互为副本。数据在多个 TiKV 之间的负载均衡由 PD 调度,这里也是以 Region 为单位进行调度。

比较

本次对比不是对MySQL数据库进行极限或压力性能测试,而是在同等软硬件环境下对选取的数据库中间件在软件/物理架构、功能特性、扩展性、SQL支持程度、容灾/容错、可用性、可维护性、接入成本等进行综合衡量。

对比点 mycat sharding-jdbc Tidb
分库分表功能 支持部分分库分表(支持单库分表,多库单表,但是不支持同时多库分表) 支持 支持
读写分离功能 支持,支持读写延时切换,支持多主模式,支持心跳监测 只支持简单的读写分离 待定
分布式事物 弱XA 当前版本不支持,未来版本支持XA事物和Base事物 完全ACID
跨库跨表的join和聚合问题 支持分页、排序、分组、聚合,内部通过堆外内存计算合并 支持分页、排序、分组、聚合,内部集成内存分组归并和流式分组归并 无
数据迁移,扩容等问题 提供迁移脚本工具(经过测试发现大数据量的时候会出现报错问题,导致迁移中断) 无 无
SQL解析 Druid解析器 自研解析器(性能高),后期规划ANTLR解析 待定
数据库连接 自研数据库连接池,存在占用连接数过大问题 SS自动选择内存限制模式和连接限制模式模式 无
数据治理 支持zk 支持zk和etcd 待定
APM监控 无 只支持sql解析和路由相关 待定
分布式主键 雪花算法、数据库序列、zk序列 雪花算法 区间分段(可能出现重复主键)
分片规则 基本支持,可自定义 基本支持,可自定义,支持多分片项 内部实现机制,无需业务制定
支持数据库 mysql、nosql(monogdb) mysql 本身就是数据库
HA haproxy+keeplive 无 水平扩展+高可用
语言 java java go
可维护性 较高(提供管控台) 较高 低(虽然提供管控台,但是由于开发语言限制与团队技术栈不一致)
接入成本 低 较高(业务方需配合) 高(业务数据需要全部迁移tidb)
社区活跃度 低 高(最近加入Apache孵化器) 高
优点 有效解决了数据库链接数多的问题,因为各工程应用只连接中间件,中间件代理了真实的物理链接,并且与后端mysql物理链接是复用型的所有的分库分表等规则集中配置在中间件上,更可控 性能高 产品较新
缺点 1.计算过程只能单节点计算,单机扩展只能调优,但是集群可以做负载均衡;
2.相对sharding-jdbc来说,由于增加一层中间代理,性能稍微降低;
3.需要保证中间件的可用性,会增加运维成本及复杂度;
4.代码排查问题弱,需要熟悉mysql协议和nio相关知识;
1.业务方需要配置多数据源,分库分表走sharding数据源,其他走主数据源(目前不支持全部数据源都走sharding,由于每次sql路由都需要做sql解析,sql解析这步会检查sql的支持项);
2.sharding-jdbc目前不支持分布式事物,和社区沟通,下个版本会支持XA和Base解决方案,目前只有sharding-proxy支持XA事物;
3.分布式主键采用雪花算法,但是没有考虑时间回拨问题(闰秒),还有业务方需要手动设置workid(这点确实不人性化);
4.客户端业务复杂,如wechat项目
1.业务数据需要全部迁移,并且生产环境配置要求较高
2.成本高

综合考虑,shardjdbc整体优于mycat,tidb由于太过新颖,在加上成本问题,可以暂不考虑。

Mycat分库分表后不支持的sql语法

  • SELECT不支持的语法

    1. 不支持跨分片的交叉查询
    2. 跨节点的联合查询,不支持union all,union
    3. mycat支持跨库2张表的join
  • INSERT不支持的语法

    1. 插入的字段不包含分片字段
    2. 插入的分片字段找不到对应分片
    3. 复制插入 insert into…select…
    4. 多行插入 insert into tab_a(c1,c2) values(v1,v2),(v11,v21)…
  • UPDATE不支持的语法

    1. 更新的列包含分片列
    2. 多表更新 update a, b set a.nation=’China’, b.pwd=’123456’ where a.id=b.id
    3. 复杂多表关联更新 update a, b set a.nation=’China’ where a.id=b.id; 但支持子查询方式 update a set a.nation=’China’ where id in (select id from b);
  • DELETE不支持语法

    1. 复杂删除sql delete a from a join b on a.id=b.id; 支持子查询方式 delete from a where a.id in (select id from b), 但表不能起别名
  • 其他

    1. Call procedure() MyCat未支持存储过程定义, 因而不允许调用存储过程,但可通过注解来调用各个分片上的存储过程
    2. Select func(); 不支持这种方式直接调用自定义函数, 但支持 select id, func() from employee 只需employee所在的所有分片上存在这个函数。MySql自带函数可随意使用。

Sharding-Jdbc分库分表后不支持的sql语法

SQL项 不支持原因
INSERT INTO tbl_name (col1, col2, …) SELECT col1, col2, … FROM tbl_name WHERE col3 = ? insert into … select …
INSERT INTO tbl_name SET col1 = ? insert … set …
SELECT DISTINCT * FROM tbl_name WHERE column1 = ? distince
SELECT COUNT(col1) as count_alias FROM tbl_name GROUP BY col1 HAVING count_alias > ? having
SELECT * FROM tbl_name1 UNION SELECT * FROM tbl_name2 union
SELECT * FROM tbl_name1 UNION ALL SELECT * FROM tbl_name2 union all
SELECT * FROM tbl_name1 WHERE (val1=?) AND (val1=?) 只支持一级冗余括号
SELECT * FROM ds.tbl_name1 不支持seheme

mycat 使用教程

mycat分库分表规则主要是修改server.xml、schema.xml和rule.xml。

  • server.xml:是Mycat服务器参数调整和用户授权的配置文件。
  • schema.xml:是逻辑库定义和表以及分片定义的配置文件。
  • rule.xml:是分片规则的配置文件,分片规则的具体一些参数信息单独存放为文件,也在这个目录下,配置文件修改需要重启MyCAT。
  1. mycat服务端server.xml配置

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    30
    31
    32
    33
    34
    35
    36
    37
    38
    39
    40
    41
    42
    43
    44
    <mycat:server xmlns:mycat="http://io.mycat/">
    <system>
    <!-- 0为需要密码登陆、1为不需要密码登陆 ,默认为0,设置为1则需要指定默认账户-->
    <property name="nonePasswordLogin">0</property>
    <!-- 1为开启实时统计、0为关闭 -->
    <property name="useSqlStat">0</property>
    <!-- 1为开启全加班一致性检测、0为关闭 -->
    <property name="useGlobleTableCheck">0</property>
    <!-- 用来指定Mycat全局序列类型,0为本地文件,1为数据库方式,2为时间戳列方式,默认使用本地文件方式,文件方式主要用于测试-->
    <property name="sequnceHandlerType">2</property>
    <!--默认为type 0: DirectByteBufferPool | type 1 ByteBufferArena-->
    <property name="processorBufferPoolType">0</property>
    <!--分布式事务开关,0为不过滤分布式事务,1为过滤分布式事务(如果分布式事务内只涉及全局表,则不过滤),2为不过滤分布式事务,但是记录分布式事务日志-->
    <property name="handleDistributedTransactions">0</property>
    <!-- 配置是否启用非堆内存跨分片结果集,1为开启,0为关闭,mycat1.6开始支持该属性-->
    <property name="useOffHeapForMerge">1</property>
    <!--单位为m-->
    <property name="memoryPageSize">64k</property>
    <!--单位为k-->
    <property name="spillsFileBufferSize">1k</property>
    <property name="useStreamOutput">0</property>
    <!--单位为m-->
    <property name="systemReserveMemorySize">384m</property>
    <!--是否采用zookeeper协调切换 -->
    <property name="useZKSwitch">false</property>
    <!-- 定义mycat使用的端口,默认值为8066 -->
    <property name="serverPort">3307</property>
    <!-- 定义mycat管理的端口,默认值为9066 -->
    <property name="managerPort">9066</property>
    </system>

    <!-- 定义登录mycat对的用户权限 -->
    <user name="root" defaultAccount="true">
    <property name="password">123456</property>
    <!-- 若要访问TESTDB 必须现在server.xml 中定义,否则无法访问TESTDB-->
    <property name="schemas">dbtest</property>
    <!-- 配置是否允许只读 -->
    <property name="readOnly">true</property>
    <!-- 定义限制前端整体的连接数,如果其值为0,或者不设置,则表示不限制连接数量 -->
    <property name="benchmark">11111</property>
    <!-- 设置是否开启密码加密功能,默认为0不开启加密,为1则表示开启加密 -->
    <property name="usingDecrypt">1</property>
    </user>
    </mycat:server>
  2. 分库分表schema.xml配置

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    30
    31
    32
    33
    34
    35
    36
    37
    38
    39
    40
    41
    42
    43
    44
    45
    46
    47
    48
    49
    50
    51
    52
    53
    54
    55
    56
    57
    58
    59
    60
    61
    <mycat:schema xmlns:mycat="http://io.mycat/">

    <!-- schema 定义mycat中的逻辑库,可以有多个逻辑库,
    1)dataNode属性:绑定逻辑库到具体的Database上面,
    2)checkSQLschema:如果为true,则会替换掉schema,如果为false则不会;
    3)sqlMaxLimit:如果带了该属性,则每次执行sql的时候如果sql没有limit则会带上这个limit,如果schema为非拆分库,则该属性不会生效。-->
    <schema name="dbtest" checkSQLschema="true" sqlMaxLimit="100">
    <!-- table标签定义了MyCat中的逻辑表,所有拆分的表都需要在table标签中定义。 -->
    <!-- 1)name属性:定义逻辑表的名称-->
    <!-- 2)dataNode属性:定义逻辑表所属的dataNode,如果需要引用多个dataNode,则可以用dataNode="dn$0-99" 来代表dn0到dn99的数据库-->
    <!-- 3)rule属性:用来指定逻辑表使用的规则名字,规则名字在rule.xml中定义。-->
    <!-- 4)ruleRequired属性:该属性用于指定表是否绑定分片规则,如果配置为true,但是没有具体的分片规则,则会报错。-->
    <!-- 5)type属性:定义逻辑表的类型,分为"全局表(global)"和"普通表"两种类型,不设置该值的时候未global的所有表。-->
    <!-- 6)autoIncrement属性:使用该值的时候需要定义auto_increment,使用的时候最好配合数据库模式的全局序列。-->
    <!-- 7)subTables属性:dataNode在分表的条件下只能配置一个,不支持各种条件的Join关联查询。-->
    <!-- 8)primaryKey属性:逻辑表对应真实表的主键。-->
    <!-- 9)needAddLimit属性:指定表是否需要字段再每个语句的后面加上limit限制。-->
    <table name="travelrecord" dataNode="dn1,dn2" primaryKey="id" rule="rule1">
    <!--childTable标签用于定义E-R分片的子表,通过标签上的属性与浮表进行关联-->
    <!-- 1)name属性:定义子表的名称-->
    <!-- 2)joinKey属性:插入子表时,回使用这个值查找浮表存贮的数据节点-->
    <!-- 3)parentKey属性:与父表建立关联关系的列名,程序首先获取joinKey的值,然后通过parentKey属性指定的列名产生查询语句,通过执行语句得知父表存储在哪个分片上,从而确定子表存贮的位置。-->
    <!-- 4)primaryKey:和table标签一样-->
    <!-- 5)needAddLimit:和table标签一样-->
    </table>
    </schema>

    <!-- dataNode标签定义了mycat中的数据节点,这也就是我们通常所说的数据分片,一个单独的dataNode就是一个独立的数据分片-->
    <!--1)name属性:定义数据节点的唯一名字-->
    <!--2)dataHost属性:定义该分片所属的数据库实例,属性引用自dataHost标签上定义的name属性-->
    <!--3)database属性:定义该分片所属的数据库实例上的具体数据库。-->
    <dataNode name="dn1" dataHost="localhost1" database="db01"/>
    <dataNode name="dn2" dataHost="localhost1" database="db02" />

    <!-- 定义数据库实例,读写分离和心跳语句-->
    <!--1)那么属性:标识唯一的dataHost,-->
    <!-- 2)maxCon属性:指定每个读写实例连接池的最大连接数。内嵌writeHost、readHost标签会使用这个属性的值来实例化连接池的最大连接数-->
    <!--3)minCon属性:指定每个读写实例连接池的最小连接数。初始化连接池的大小的属性。-->
    <!--4)balance属性:负债均衡类型,有四种-->
    <!-- balance="0" : 不开启读写分离机制,所有的读操作都发送到当前可以用的writeHost上-->
    <!-- balance="1" : 全部的readHost与stand by writeHost(双主从模式下的master) 都参与select语句的负债均衡-->
    <!-- balance="2" : 所有的读操作都随机的往writeHost和readHost上分发-->
    <!-- balance="3" : 所有的读分发到readHost上,writeHost负责写-->
    <!--5)writeType属性:负载均衡目前的取值有两种:-->
    <!-- writeType="0":所有的写操作都发送到第一个writeHost,writeHost1挂了,则切换到writeHost2上,重新恢复writeHost1后,还是以writeHost2为准-->
    <!-- writeType="1":所有的写操作都随机的发送到配置的writeHost上,1.5版本以后不推荐使用该值。-->
    <!--6)dbType属性:制定后端后端数据的类型:mysql,oracle、mongoDB-->
    <!--7)dbDriver属性:制定后端数据库使用的Driver.目前可选的值为native和JDBC。-->
    <!--8)switchType属性:默认值为1,自动切换。-->
    <!-- -1表示不自动切换-->
    <!-- 2表示基于mysql主从同步的状态决定是否切换。-->
    <!-- 3表示基于mysql galaxy cluster 的切换机制-->
    <!--9)tempReadHostAvailable属性:如果配置了writeHost属性,下面的readHost依旧可以使用,默认为0-->
    <dataHost name="localhost1" maxCon="1000" minCon="10" balance="0"
    writeType="0" dbType="mysql" dbDriver="native" switchType="1" slaveThreshold="100">
    <heartbeat>select user()</heartbeat>
    <writeHost host="hostM1" url="127.0.0.1:3306" user="root" password="123456"> <!-- url、user、password 设置成你的数据库 -->
    </writeHost>
    </dataHost>

    </mycat:schema>
  3. 分库分表规则rule.xml配置

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    <mycat:rule xmlns:mycat="http://io.mycat/">
    <!--name 属性指定唯一的名字,用于标识不同的表规则
    1)内嵌的 rule 标签则指定对物理表中的哪一列进行拆分和使用什么路由算法。
    2)columns 内指定要拆分的列名字。
    3)algorithm 使用 function 标签中的 name 属性。连接表规则和具体路由算法。当然,多个表规则可以连接到同一个路由算法上。 table 标签内使用。让逻辑表使用这个规则进行分片。
    -->
    <tableRule name="rule1">
    <rule>
    <columns>id</columns>
    <algorithm>func1</algorithm>
    </rule>
    </tableRule>

    <!--name 指定算法的名字。
    1)class 制定路由算法具体的类名字。
    2)property 为具体算法需要用到的一些属性。
    -->
    <function name="func1" class="io.mycat.route.function.PartitionByLong">
    <property name="partitionCount">2</property>
    <property name="partitionLength">512</property>
    </function>

    </mycat:rule>

sharding-jdbc 使用教程

  1. maven依赖包
    1
    2
    3
    4
    5
    <dependency>
    <groupId>io.shardingsphere</groupId>
    <artifactId>sharding-jdbc</artifactId>
    <version>${sharding-sphere.version}</version>
    </dependency>
    Read more »

背景

***公司系统间的数据同步通过http接口通信,这种方式会导致数据同步高峰期间nginx的负载流量增加,从而影响业务流量。其二就是http方式的不稳定性,会导致一些数据不一致的问题。针对这个现象,目前提出2中解决方式,第一种可以通过高可用消息队列来进行解耦,第二种通过数据库底层binlog来监听数据变化。

otter介绍

otter为阿里的一款增量数据同步工具,基于数据库增量日志解析,准实时同步到本机房或异地机房的mysql/oracle数据库.一个分布式数据库同步系统。

otter工作原理

原理描述:

  1. 基于Canal开源产品,获取数据库增量日志数据。
  2. 典型管理系统架构,manager(web管理)+node(工作节点).manager运行时推送同步配置到node节点.node节点将同步状态反馈到manager上.
  3. 基于zookeeper,解决分布式状态调度的,允许多node节点之间协同工作.

Otter目前支持了什么

  1. 单向同步, mysql/oracle互相同步
  2. 双向同步,无冲突变更
  3. 文件同步,本地/aranda文件
  4. 双A同步,冲突检测&冲突补救
  5. 数据迁移,中间表/行记录同步

    典型的场景是账户信息表和账户交易明细表,更新账户余额后需要登记一条账户明细,并且保证在一个事务里,用户可以通过交易明细表查看交易记录,但是交易明细表的数据量是逐步递增的,用户量多的系统,几个月下来的数据超过千万了,表数据量一多就导致查询和插入变慢,而一开始就对账户明细做分表处理就难于保证强一致性事务,通过otter可以将记录同步导历史表,并且进行分表处理,用户往年的交易记录就可以查询历史表了,而原交易明细表就可以删除一个月甚至几天前的数据;

Read more »

  • 拉取镜像

    docker pull daocloud.io/library/mysql:5.6

  • 创建容器

    docker run -p 3306:3306 –name mysql -v /Users/peijiepang/Documents/docker/mysql/conf:/etc/mysql -v /Users/peijiepang/Documents/docker/mysql/data:/var/lib/mysql -e MYSQL_ROOT_PASSWORD=123456 -d daocloud.io/library/mysql:5.6

  • 获取所有的容器id

    docker ps -a

  • 启动容器

    docker start 578fcc293e25

  • 查看当前启动的容器

    docker ps

  • 进去容器内部系统

    sudo docker exec -it 578fcc293e25 /bin/bash

  • 退出容器

    exit/ctrl+c

  • 容器重启

    docker restart 容器id

Read more »

利用top命令查找异常进程

top

输入top命令后,可以按P(shift+p)根据cpu占用排序、按M根据内存占用排序、按T根据运行时间排序。

这里先按P根据cpu排序查找异常的线程: